
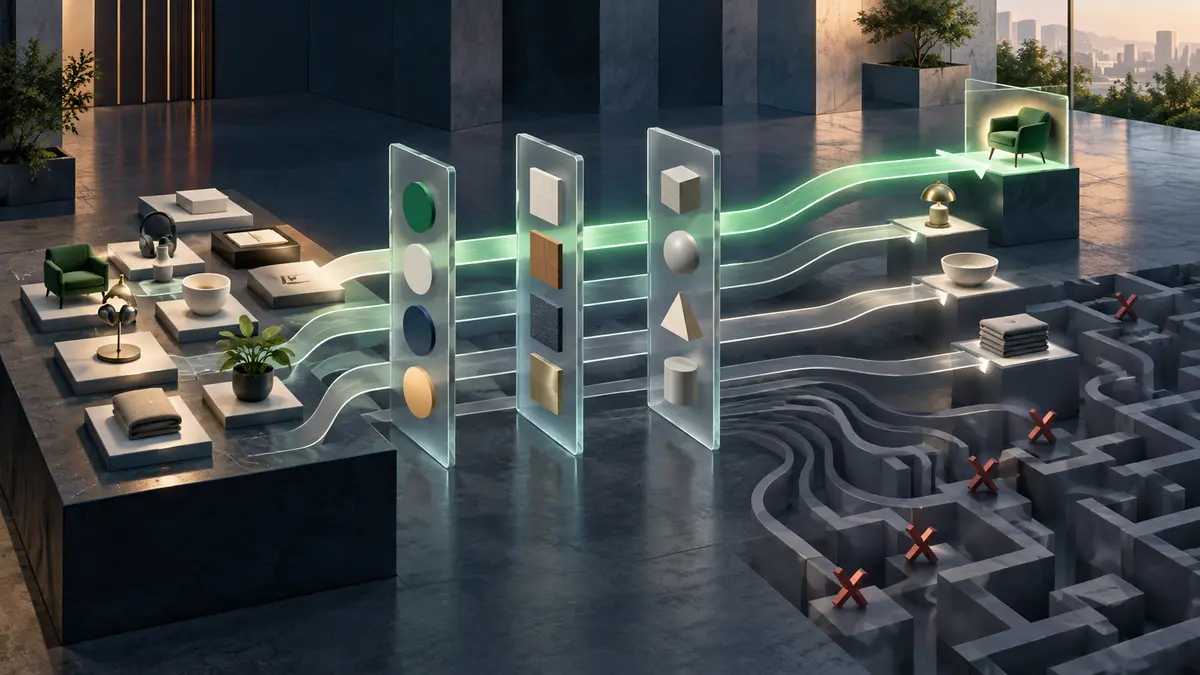
Короткий ответ: индексировать нужно не все сочетания фильтров, а только заранее выбранные страницы с самостоятельным спросом и полезным ассортиментом. Для них создают постоянный URL, self-canonical, уникальные title и H1, внутренние ссылки. Остальные комбинации оставляют инструментом выбора: не добавляют в sitemap, не продвигают ссылками и не дают им создавать бесконечное число адресов. Карточки товаров или услуг при этом должны быть доступны роботу через категории и подборки, без перебора фильтров.
Что такое фасетная навигация
Фасетная навигация — система фильтров, где каждый признак меняет состав выдачи. В каталоге кресел посетитель выбирает материал, цвет, подголовник и цену. В каталоге услуг фасетами могут быть город, отрасль и тип задачи.
Не путайте фильтр с сортировкой. Фильтр меняет набор объектов, а сортировка только переставляет его. Страница «зелёные кресла» может отвечать отдельному запросу. Версия «сначала дешёвые» обычно не становится новой посадочной.
Почему возникают дубли
Одна выборка часто открывается по разным адресам из-за порядка параметров, регистра и меток. Например, color=green&brand=alpha и brand=alpha&color=green могут показывать один список. Если обе версии отвечают 200, робот обходит дубли. Есть и слабые страницы: комбинация работает, но содержит случайный товар и не отвечает ясному запросу. Шаблонный текст это не исправляет.
Особенно опасны бесконечные маршруты: выбор и снятие значений, произвольная цена, вид сетки, размер выдачи, сортировка. Если интерфейс публикует ссылку на каждое состояние, число URL быстро выходит из-под контроля. Подробнее об этом — в материале о краулинговом бюджете и лишних URL.
Какие страницы можно индексировать
Страница-кандидат должна пройти четыре проверки:
- Есть отдельный интент. Люди ищут это сочетание как понятную категорию.
- Есть устойчивое наполнение. Выборка не исчезает после каждого обновления и не держится на одном случайном объекте.
- Страница полезна сама по себе. Заголовок, список и навигация помогают выбрать, а текст не маскирует пустой каталог.
- Есть место в структуре. На страницу ведут осмысленные ссылки из категории, меню, подборки или статьи.
Спрос проверяют по семантике, внутреннему поиску, обращениям и данным бизнеса. Универсального порога по числу запросов или товаров нет.
Пошаговая настройка
1. Разделите параметры на классы
Соберите все фильтры в таблицу и распределите по трём группам:
- потенциальные посадочные: тип, бренд, материал, город или другой признак с подтверждённым спросом;
- пользовательские фильтры: редкие характеристики, сочетания значений, индивидуальные диапазоны;
- служебные режимы: сортировка, вид сетки, число карточек, валюта, UTM-метки.
Для каждой группы задайте базовое поведение. Если команда не может объяснить пользу конкретной комбинации, не открывайте её поиску.
2. Выберите единый формат URL
Посадочная может жить по пути /chairs/green/ или на нормализованных параметрах. В обоих случаях порядок, регистр и кодирование должны быть стабильны. Удаляйте пустые параметры, повторы и метки. Однозначные дубли перенаправляйте на основной URL, а canonical используйте как дополнительный сигнал.
3. Создайте белый список
Безопаснее хранить конечный список разрешённых посадочных, чем перечислять все запрещённые варианты. Для каждой страницы укажите URL, title, description, H1, хлебные крошки, источник ссылок и правило на случай пустой выдачи.
Не применяйте правило «индексировать любое сочетание двух фильтров»: оно не учитывает спрос и ассортимент.
4. Настройте canonical по содержимому
Разрешённая фильтр-страница получает self-canonical на собственный чистый URL. Сортировка, меняющая только порядок тех же карточек, может ссылаться на основной адрес выборки. Страница с другим набором объектов не становится дублем категории только потому, что так удобнее разработчику.
Не направляйте canonical всех комбинаций на категорию: это не прекращает обход. Сначала уберите источники мусорных URL, затем канонизируйте эквивалентные версии. Подробнее — в гайде по sitemap, robots.txt и canonical.
5. Управляйте внутренними ссылками
На выбранные посадочные ведите HTML-ссылки из категорий и подборок. Технические состояния не должны получать сквозные ссылки. Не полагайтесь на nofollow и не закрывайте все параметры в robots.txt: робот не увидит canonical или noindex.
6. Обработайте пустые и ошибочные выборки
Неизвестное значение должно возвращать 404, а не пустой каталог с кодом 200. Важную временно пустую посадочную можно сохранить с честным сообщением и альтернативами. Не перенаправляйте любой пустой фильтр на категорию: это неточная замена.
7. Согласуйте пагинацию
Большая разрешённая выборка получает собственную цепочку пагинации. Страница 2 сохраняет выбранные значения и ставит canonical на себя, если цепочка входит в открытый контур. Версия page=1 не должна дублировать начало.
Проверьте сочетание фильтра, сортировки и номера страницы. Подробнее — в статье о пагинации без дублей.
8. Ограничьте диапазоны и множественный выбор
Произвольные границы цены создают почти бесконечное число URL. Для SEO оставляйте фиксированные диапазоны только при устойчивом спросе. Ползунок с любыми значениями должен быть функцией интерфейса, а не генератором посадочных.
Множественный выбор редко соответствует ясному запросу. Нормализуйте порядок значений и не включайте такие комбинации в sitemap. Востребованное объединение оформите как отдельную подборку.
Пример: каталог светильников
В магазине есть фильтры по типу, помещению, цвету, бренду, цене и наличию. После анализа спроса команда выбирает страницы «подвесные светильники», «светильники для кухни» и несколько сочетаний типа с помещением. Они получают постоянные URL, self-canonical, метатеги и ссылки из категории.
Цвет, наличие, свободная цена, сортировка и множественный выбор остаются пользовательскими состояниями. Их нет в sitemap и редакционных ссылках. Параметры приводятся к единому формату, неизвестные значения возвращают 404.
Если подборка пустеет, ответственный решает: оставить альтернативы или убрать страницу из открытого контура. После запуска сайт обходят с JavaScript и без него, URL сверяют с логами. Цель — доступные карточки и отсутствие лишних маршрутов, а не максимальный индекс.
Как проверить результат
Сначала проведите технический обход. Разделите URL на категории, разрешённые фильтры, запрещённые сочетания, сортировки, диапазоны, пагинацию и ошибки. Для каждой группы проверьте код ответа, canonical, robots, title, H1 и входящие ссылки.
Затем изучите серверные логи: какие параметры робот запрашивает, откуда находит их и остаются ли полезные карточки вне обхода. Если мусорные адреса появляются снова, ищите генератор — шаблон ссылки, старый sitemap или сохранённый параметр. Одна директива не остановит продолжающуюся генерацию.
В поисковых панелях смотрите примеры исключённых и канонических страниц, а не только итоговое число. В аналитике отделите фасетные посадочные от обычных категорий и проверьте, соответствует ли вход запросу. При массовой проблеме поможет инструкция как найти и устранить дубли страниц.
Ограничения
Белый список требует поддержки: ассортимент, спрос и структура меняются. Нужен владелец правил и регулярная проверка. Canonical не гарантирует выбор указанного URL, если остальные сигналы ему противоречат. Noindex, robots.txt и JavaScript тоже не исправляют плохую архитектуру ссылок. Решение нельзя принимать только по числу товаров — важны интент, стабильность выборки и её роль на сайте.
Частые ошибки
- Открыть все сочетания. Техническая возможность не равна поисковой ценности.
- Закрыть параметры только в robots.txt. Робот не увидит директивы страницы, а источники URL останутся.
- Ставить canonical всех фильтров на категорию. Обход мусора продолжится, полезные посадочные потеряют самостоятельность.
- Генерировать шаблонные тексты. Замена цвета в одном абзаце не делает страницу полезной.
- Добавлять в sitemap сортировки и случайные фильтры. Карта сайта должна содержать только выбранные канонические URL.
- Не нормализовать параметры. Одна выдача получит несколько адресов.
- Возвращать 200 для неизвестных значений. Ошибочные URL будут выглядеть существующими.
- Забывать о пагинации и владельце правил. Дубли продолжат расти, а пустые посадочные останутся незамеченными.
Практический чек-лист
- все параметры перечислены и разделены на классы;
- индексируемые сочетания внесены в конечный белый список;
- для каждой посадочной подтверждены интент и устойчивое наполнение;
- одинаковые состояния сведены к одному URL, порядок параметров нормализован;
- разрешённые страницы имеют self-canonical, H1 и уникальные метатеги;
- сортировки, диапазоны и аналитические метки не стали посадочными;
- неизвестные значения и пустые выборки получают ожидаемый статус;
- важные страницы имеют HTML-ссылки, технических комбинаций нет в sitemap;
- пагинация наследует статус выборки;
- карточки доступны без перебора фильтров;
- обход выполнен с JavaScript и без него, логи проверены по шаблонам;
- после обновления ассортимента проверяются пустые посадочные.
Как поставить задачу разработчику
Передайте разработчику матрицу примеров: полезная посадочная, тот же набор с другим порядком параметров, сортировка, диапазон, пустая комбинация, неизвестное значение и вторая страница. Для каждого URL задайте status, canonical, robots, наличие ссылки и sitemap. При приёмке проверьте нормализацию, метаданные, доступность карточек и отсутствие запрещённых комбинаций в ссылках. После изменений запустите регрессионный обход.
Черновик матрицы, метатеги и тест-кейсы можно подготовить в нейросети XelaGroup. Итоговые правила всё равно нужно сверить с реальным спросом, ассортиментом, краулером и логами. Если нужен аудит фильтров с приоритетами исправлений, напишите в Telegram.
FAQ
Нужно ли закрывать от индексации все страницы фильтров?
Нет. Полноценными посадочными могут быть страницы со спросом, устойчивым наполнением и местом в структуре. Открывайте только выбранный конечный набор.
Что лучше: ЧПУ или параметры?
Оба варианта работают. Важнее единый URL, корректный canonical и отсутствие дублей, чем внешний вид адреса.
Поможет ли robots.txt избавиться от дублей?
Нет. Запрет ограничивает обход, но не убирает ссылки и мешает прочитать canonical или noindex. Сначала нормализуйте URL и открытый контур.
Можно ли ставить canonical всех фильтров на категорию?
Только для действительно эквивалентных страниц. Полезной посадочной нужен self-canonical, а технические URL не следует генерировать и распространять.
Какие страницы добавлять в sitemap.xml?
Только разрешённые канонические посадочные. Сортировки, диапазоны и случайные сочетания туда не входят.
Что делать с временно пустой полезной страницей?
Если ассортимент скоро вернётся, страницу можно оставить с сообщением и альтернативами. Если точной замены нет и выборка исчезла надолго, уберите ссылки и отдайте подходящий статус.
Как понять, что фильтры настроены правильно?
Полезные страницы доступны по ссылкам, карточки находятся без перебора параметров, а логи не показывают обход бесконечных сочетаний. Число URL в индексе само по себе не цель.